Veroeffentlicht: 28.03.2026 | Lesedauer: 2 min read
CI/CD Stabiler gemacht - Buildx Lock-Fehler behoben
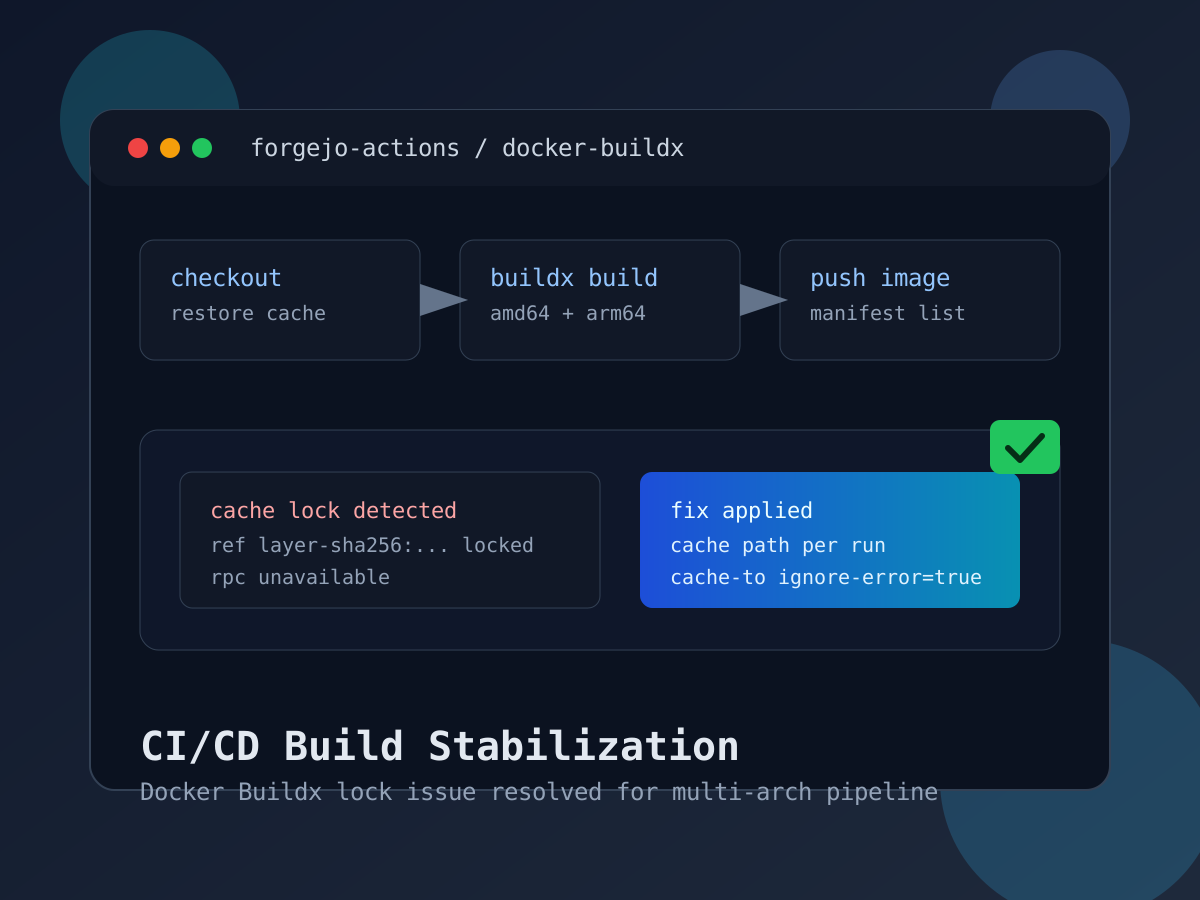
Heute habe ich einen nervigen CI/CD-Fehler in meiner Pipeline gefixt: Der Multi-Arch-Build lief eigentlich durch, ist aber ganz am Ende beim BuildKit-Cache ausgestiegen.
Inhaltsverzeichnis
Fehlerbild im Log
Im Log konnte ich sehen, dass der Build für linux/amd64 und linux/arm64 sauber durchlief, inklusive npm run build und Image-Export. Danach kam mehrfach dieser Fehler:
rpc error: code = Unavailable desc = ref layer-sha256:... locked ...: unavailableDas ist ein typisches Symptom für einen Lock-Konflikt beim Schreiben in einen lokalen Buildx-Cache.
Was die Ursache war
Im Workflow war der Cache-Pfad statisch gesetzt:
CACHE_DIR: /tmp/.buildx-cacheWenn mehrere Runs oder Worker denselben lokalen Pfad nutzen, knallt es früher oder später bei den Layer-Locks. Genau dadurch entstehen diese sporadischen Unavailable-Fehler, obwohl der eigentliche Build schon fertig ist.
Mein Fix im Workflow
Ich habe in .forgejo/workflows/build.yml zwei kleine, aber wichtige Änderungen gemacht:
CACHE_DIR: /tmp/.buildx-cache-${{ github.run_id }}-${{ github.run_attempt }}...cache-to: type=local,dest=${{ env.CACHE_DIR }},mode=max,ignore-error=trueWarum das funktioniert:
- Run-spezifischer Cache-Pfad verhindert Lock-Kollisionen zwischen parallelen Jobs.
ignore-error=truestellt sicher, dass ein Problem beim Cache-Export nicht den ganzen Build rot macht.
Nebenbei noch verbessert
Wenn ich schon dabei bin, habe ich direkt noch zwei Dinge aufgeräumt:
-
Astro-Konfiguration erweitert (
astro.config.mjs)- globale
image.service.configDefaults fürjpeg,webp,avif,png - deutsche
smartypants-Anführungszeichen („...“,‚...‘)
- globale
-
Warnungen in den Checks entfernt (
src/content/config.ts)- Wechsel von
zausastro:contentaufzausastro/zod - Ergebnis:
make checkohne Warnungen
- Wechsel von
Fazit
Mein Takeaway: Wenn man lokale Buildx-Caches auf selbst gehosteten Runnern nutzt, sollte der Cache-Pfad immer pro Run eindeutig sein.
Zusammen mit ignore-error=true beim Cache-Export bleibt die Pipeline stabil, auch wenn der Cache-Write mal hängt. Der Build selbst soll dann trotzdem erfolgreich durchlaufen.